


Anthropic прагне зробити AI-згенерований текст простішим для розпізнавання, і теоретично мені майже немає на що скаржитися. Компанія експериментує з invisible watermark, який можна вбудувати безпосередньо в текст, створений Claude.
На перший погляд це виглядає розумним кроком. Текст від ШІ вже всюди, і розуміння походження матеріалу справді може допомогти. До того ж Anthropic не просто ховає «мітку» десь у документі: її метод змінює те, як Claude обирає слова, формуючи статистичний візерунок, який згодом можна виявити.
Однак мене непокоїть один нюанс. Anthropic перевіряє, наскільки стійкою може бути водяна мітка навіть після того, як текст було відредаговано.
І саме тут я вже відчуваю, що можуть початися проблеми.
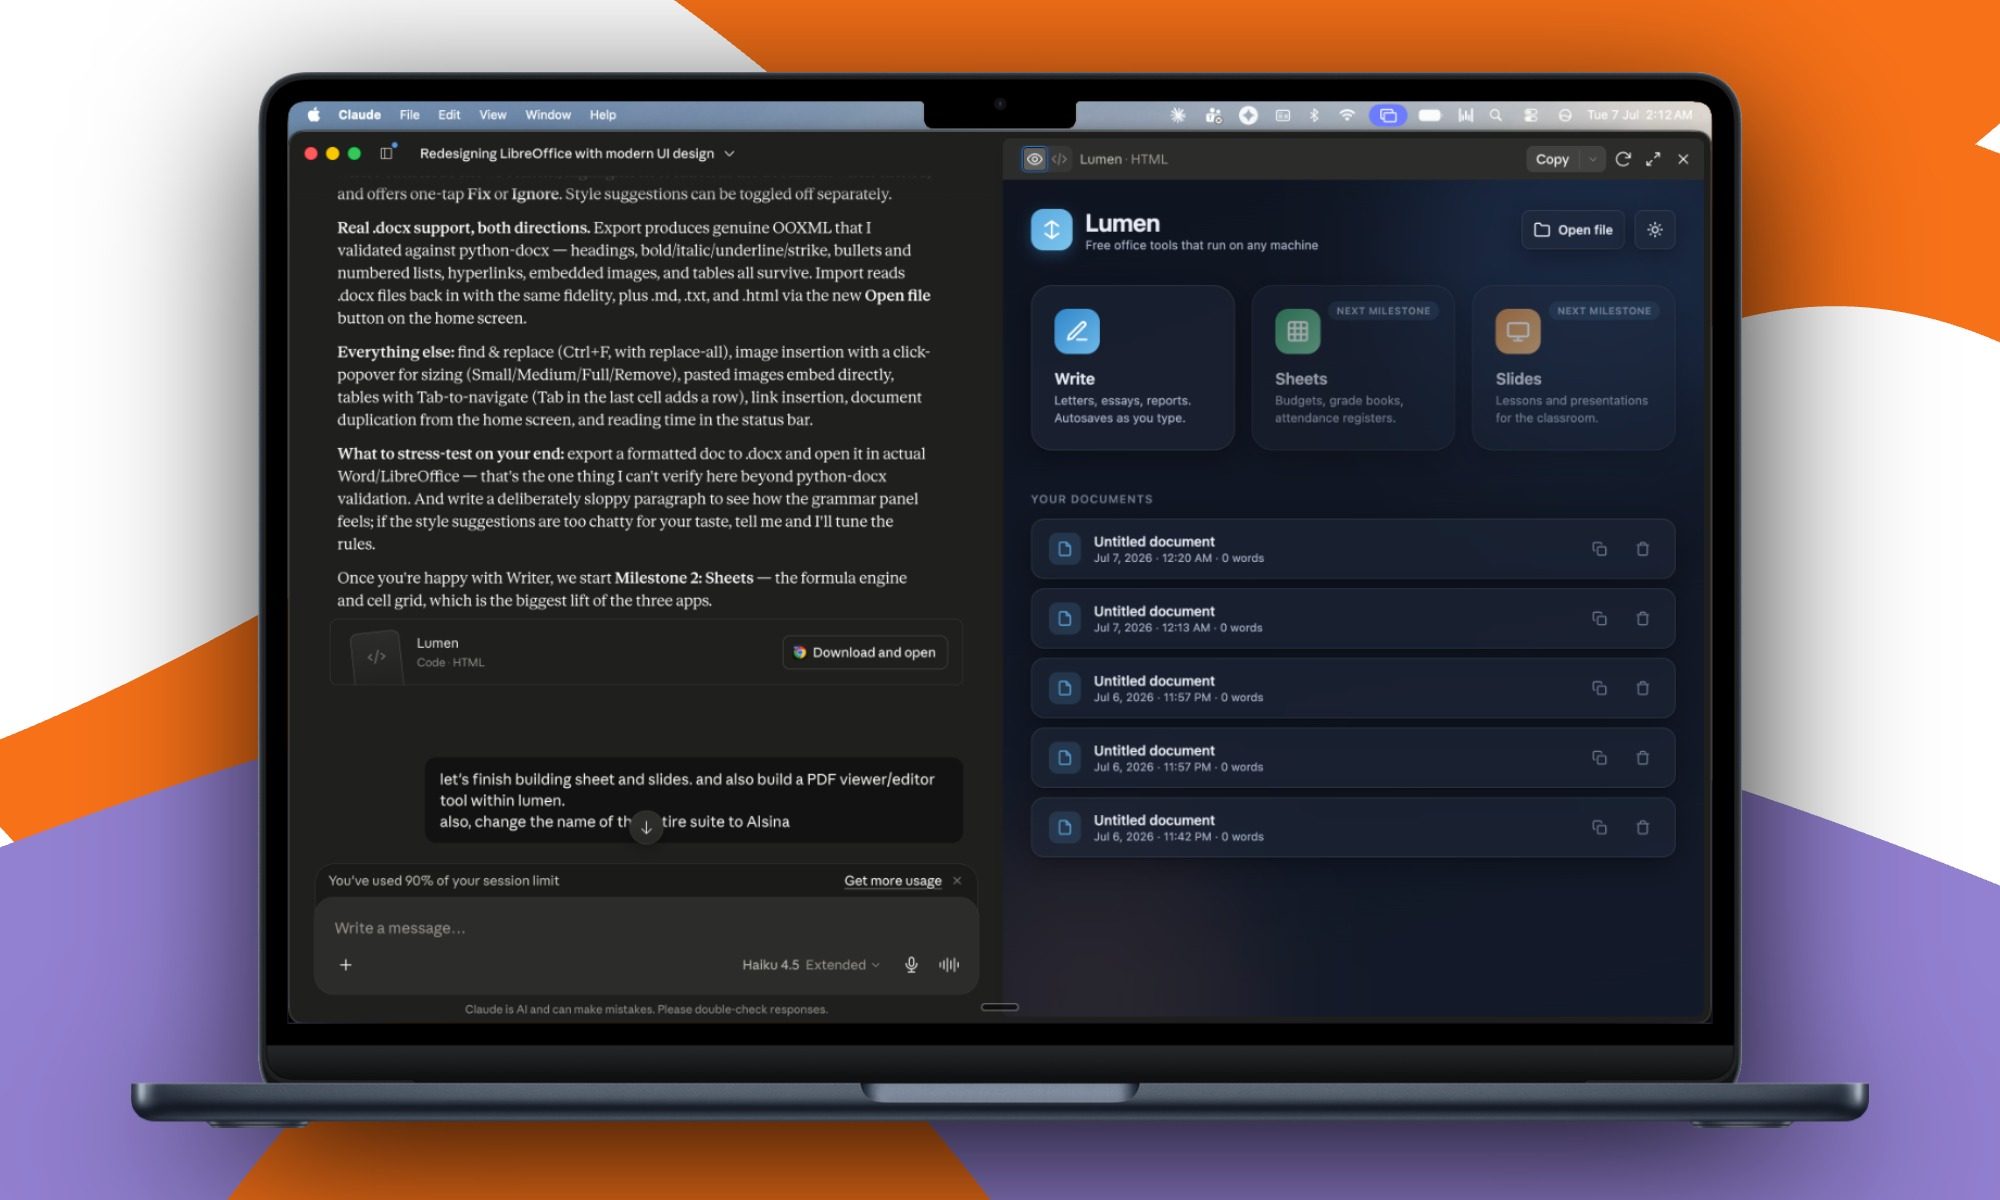
Claude торкнувся мого тексту: чи означає це, що він його написав?
Подумаймо про переклад. Уявімо, що людина самостійно пише ціле есе іспанською, а потім просить Claude перекласти його англійською. Ідеї — її. Дослідження — її. Аргументи — також її. Роль Claude зводиться лише до перекладу.
Та попри це підсумковий англомовний текст усе одно може містити водяний знак Claude.
Подібна дилема виникає й під час вичитування. А якщо автор написав усе сам і звернувся до Claude лише для виправлення граматики? Або попросив скоротити абзац, змінити тон, привести до ладу продиктований текст чи просто зробити незграбне речення читабельнішим?
Це вже давно не «рідкісні сценарії». Люди дедалі частіше користуються асистентами на кшталт ChatGPT, Gemini та Claude для повсякденних завдань, які мало пов’язані зі створенням оригінального контенту з нуля. Водяний знак здатен показати, що Claude був залучений до тексту, але він не може довести, чи написав Claude роботу. Anthropic говорить про це прямо: мітка відображає участь Claude, а не те, хто створив первинний матеріал.
А тепер уявіть, як пояснювати цю різницю викладачеві після того, як його система перевірки щойно позначила ваше есе.

Ми вже бачили, наскільки хаотично працює AI-детекція
Я б хвилювався значно менше, якби our track record with AI detection був справді переконливим. Але він таким не є.
MIT Sloan’s guidance доволі однозначна щодо наявних детекторів ШІ. Там зазначено, що вони мають high error rates і можуть призводити до того, що викладачі помилково звинувачують студентів у порушеннях.
Ми вже спостерігали це в реальному житті. Students have found themselves defending work they say they wrote themselves після того, як автоматизовані системи визначили їхні тексти як згенеровані ШІ. В одному випадку, описаному The Guardian, есе студента було позначено як повністю AI-згенероване, хоча він стверджував, що використовував лише дозволену допомогу зі спелінгом і граматикою. Зрештою апеляцію задовольнили.
Щоб було зрозуміло: водяний знак Claude — це інший підхід. Звичайні AI detectors аналізують стиль і лише оцінюють імовірність того, що текст міг бути створений ШІ. Anthropic же навмисно вбудовує у вихідний текст Claude сигнал, який потім можна виявити. У теорії це має зробити систему значно надійнішою. Але проблема тут не тільки в надійності — ключове питання в інтерпретації.
Дійшло до абсурду: AI доводить, що ми не користувалися AI
Ситуація вже виглядає дещо гротескно.
Студенти, які бояться перевірок на ШІ, turning to so-called AI humanizers — інструментів, що переписують текст так, аби він рідше «спрацьовував» на детекторах. Дехто застосовує їх навіть до власноруч написаних робіт, оскільки боїться хибних спрацювань. А компанії, які продають детектори, у відповідь створюють методи виявлення «humanizers».
Прочитайте це ще раз.
Людина може написати текст сама, потім занепокоїтися, що AI вирішить, ніби це написав AI, пропустити роботу через інший AI, щоб зробити її «людянішою», а далі ще одна система оцінюватиме, чи AI зробив її схожою на людську.
Це технологічний уроборос.
Технічно вражає те, що Anthropic намагається зробити водяний знак Claude достатньо живучим, щоб він переживав редагування та переклад. Попередні дослідження показували, що переклад може ламати деякі техніки водяних знаків у тексті, тож усунення цього слабкого місця було б реальним прогресом.
Але мені здається, що «міцніший» сигнал не розв’язує головної проблеми: як його трактуватимуть.
Водяний знак має працювати лише разом із контекстом
Водяні знаки для AI-контенту мають цілком логічні застосування. Вони можуть допомогти знаходити масово створену дезінформацію, прихований синтетичний текст або матеріали, написані ШІ, які згодом потрапляють у навчальні набори даних.
Та біда в тому, що сучасні AI-асистенти роблять набагато більше, ніж пишуть тексти «з нуля». Ними користуються для перекладу, редактури, конспектування досліджень, допомоги з кодом, покращення доступності або просто щоб відшліфувати лист перед відправленням. У такому середовищі факт участі ШІ ще не означає, що він є справжнім автором.
Ступінь залучення ШІ в цих сценаріях радикально різниться. Якщо Claude генерує есе від початку до кінця, це важливий сигнал. Якщо Claude лише перекладає текст, який хтось писав і досліджував три тижні, то сама присутність Claude у процесі повідомляє значно менше.
Водяний знак може бездоганно відповідати на запитання «Чи торкався цього Claude?». Мене турбує інше: що буде, коли відповідь почнуть сприймати як доказ того, що «Це написав Claude».
Anthropic може створити найрозумніший водяний знак у світі. Але якщо люди, які ним користуються, не розумітимуть цієї різниці, я підозрюю, що проблем не уникнути.


